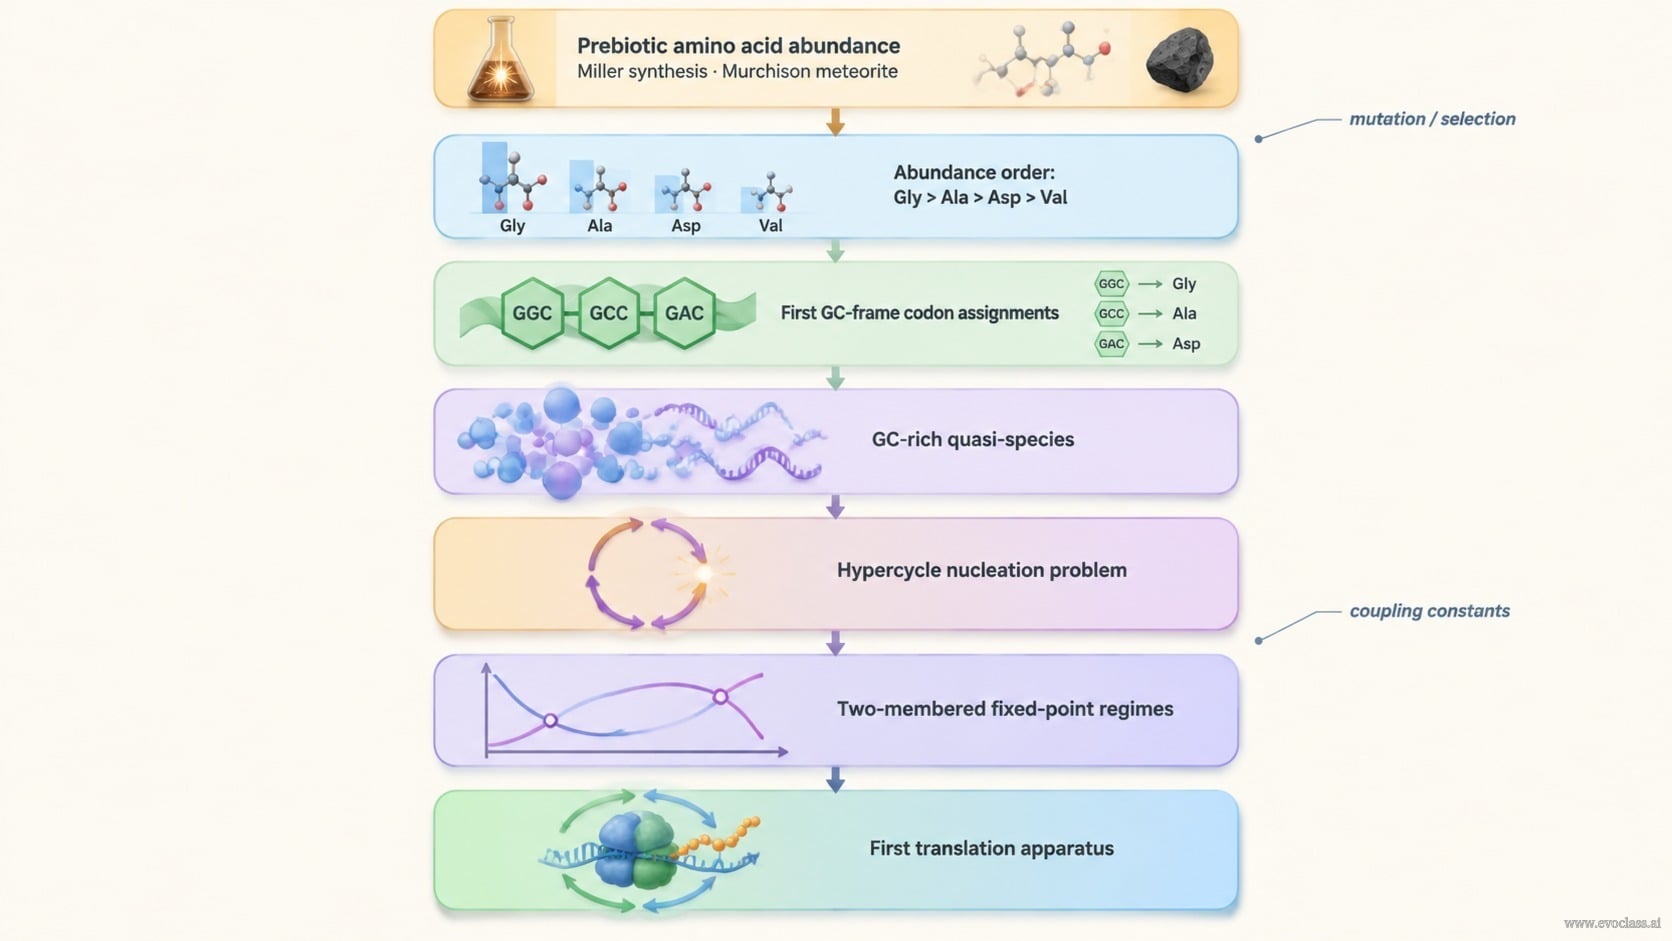
Nguồn gốc của quá trình dịch mã thường được hình dung như sự lắp ráp đột ngột của một ribosome. Slide này đi theo một hướng khác: nó bắt đầu từ sự phong phú tiền sinh học của các axit amin và đặt câu hỏi bộ máy dịch mã đầu tiên phải là một phần của tổ chức bậc cao nào.
Từ hóa học tiền sinh học đến bảng chữ cái đầu tiên
Tổng hợp tiền sinh học mô phỏng (các thí nghiệm kiểu Miller) và kho dự trữ hữu cơ của thiên thạch Murchison đều hội tụ về một họ giới hạn các axit amin mạch thẳng. Không phải một hỗn hợp đồng đều, sản lượng và độ phong phú trong thiên thạch có xu hướng lệch mạnh: glycine chiếm ưu thế, tiếp theo là alanine, axit aspartic và valine. Sự lệch này chính là nguyên liệu thô để tạo nên bảng chữ cái di truyền đầu tiên.
Thứ tự phong phú và các codon khung GC đầu tiên
Thứ tự Gly > Ala > Asp > Val được dùng để sắp xếp các gán codon khung GC đầu tiên. Các codon được tạo từ G và C ánh xạ trước tiên vào những axit amin đơn giản và phong phú nhất, nhờ đó độ phong phú hóa học và kiểu mã hóa sơ khai được gắn kết với nhau. Theo cách hiểu này, hệ thống mã hóa sớm nhất là một hệ thống giàu GC, và các gán của nó là hệ quả của sự sẵn có chứ không phải ngẫu nhiên.
Vấn đề tạo mầm của siêu chu trình
Siêu chu trình hoạt động khác với một bản sao tự xúc tác đơn lẻ. Về nguyên tắc, một bản sao có thể bắt đầu từ một bản khuôn đơn lẻ; một mạng lưới dạng chu trình thì không, vì việc khép kín vòng lặp đòi hỏi tất cả các thành viên của nó phải hiện diện cùng lúc. Do đó, bộ máy dịch mã đầu tiên không phải là một phát minh phân tử đơn độc. Nó phải được lắp ráp dần dần từ một bán loài giàu GC, với đột biến và chọn lọc bổ sung và tinh chỉnh các thành phần của nó từng bước cho đến khi chu trình khép kín.
Các điểm bất động của siêu chu trình hai thành viên
Phân tích điểm bất động của một siêu chu trình hai thành viên cho thấy kết quả phụ thuộc vào các hằng số ghép nối tương đối liên kết các thành viên. Ba chế độ định tính xuất hiện: cạnh tranh trực tiếp, trong đó một thành viên lấn át thành viên kia; chọn lọc một trong hai thành viên, tùy thuộc vào điều kiện ban đầu; và ổn định siêu chu trình lẫn nhau, trong đó mỗi thành viên củng cố thành viên kia. Chỉ chế độ cuối cùng mới hỗ trợ một bộ máy ghép nối dịch mã, vì đây là trường hợp sao chép RNA và tổng hợp peptide củng cố lẫn nhau thay vì cạnh tranh.
Dịch mã như một ngưỡng, không phải một phát minh
Bức tranh hiện ra là bộ máy dịch mã đầu tiên là một ngưỡng trong một hệ siêu chu trình liên kết sao chép RNA, tổng hợp peptide và khép kín xúc tác. Câu hỏi dẫn đường là XI. Làm thế nào để khởi đầu dịch mã? Lộ trình ở trên trả lời câu hỏi đó: điểm khởi đầu là độ phong phú hóa học, và điểm kết thúc là một chu trình tự củng cố đạt được thông qua đột biến, chọn lọc và sự ghép nối đầy đủ.
Các axit amin tiền sinh học và bộ máy dịch mã đầu tiênMột lộ trình theo từng giai đoạn kết nối sự phong phú axit amin nguyên thủy (tổng hợp kiểu Miller và dữ liệu thiên thạch Murchison) với bộ máy dịch mã đầu tiên. Lộ trình đi qua thứ tự phong phú Gly > Ala > Asp > Val, các gán codon khung GC sớm nhất, một bán loài giàu GC, vấn đề tạo mầm của siêu chu trình, và các chế độ điểm bất động của một chu trình hai thành viên, kết thúc tại một bộ máy dịch mã được gắn kết bởi sao chép RNA, tổng hợp peptide và khép kín xúc tác.